ทำความรู้จัก Mixture-of-Experts (MoE) แบบง่ายที่สุด
เวลาเราสร้างโมเดล AI ขนาดใหญ่ขึ้นเรื่อยๆ เรามักจะติดปัญหาว่ามันกินทรัพยากรเครื่องมหาศาล เพราะทุกครั้งที่ AI ประมวลผลคำสั่ง มันต้องใช้ทุกส่วนของสมองที่มีในการคิดเลข Mixture-of-Experts (MoE) หรือโมเดลแบบแบ่งผู้เชี่ยวชาญ จึงเข้ามาแก้ปัญหานี้ด้วยแนวคิดที่ว่า ไม่จำเป็นต้องใช้สมองทั้งหมดเพื่อตอบคำถามเดียว
ลองนึกภาพว่าคุณมีทีมงาน 10 คน ถ้าคุณถามเรื่องการเขียนโค้ด คุณคงไม่เรียกทั้ง 10 คนมาช่วยกันตอบ แต่คุณจะเลือกเฉพาะ Expert (ผู้เชี่ยวชาญ) ที่ถนัดเรื่องการเขียนโปรแกรมมาตอบคุณ 2-3 คนก็พอ แนวคิดนี้คือหัวใจของ MoE ที่ช่วยให้ AI ฉลาดขึ้นได้โดยไม่ทำให้คอมพิวเตอร์ทำงานหนักจนเกินไป
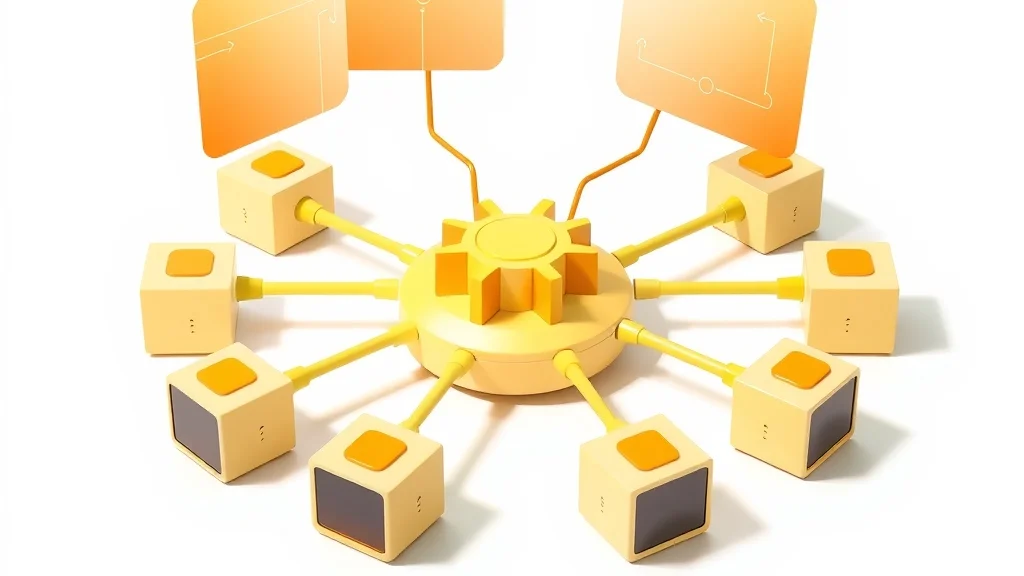
ในโมเดลแบบปกติที่เรียกว่า Dense Model (โมเดลแบบหนาแน่น) ข้อมูลทุกอย่างจะไหลผ่านทุกส่วนของสมอง AI เสมอ แต่ในโมเดล MoE จะมีตัว Router (ตัวคัดเลือกเส้นทาง) ทำหน้าที่เป็นเหมือนหัวหน้างาน คอยดูคำถามแล้วส่งต่อไปยังผู้เชี่ยวชาญที่เหมาะสมที่สุดในแต่ละชั้น ทำให้เราขยายขนาดความรู้ของ AI ได้โดยไม่ต้องแลกมาด้วยความเร็วที่ลดลง
วิวัฒนาการจาก Mixtral สู่โมเดลที่ใหญ่ขึ้น
โมเดล Mixtral 8x7B เป็นตัวอย่างที่ชัดเจนที่สุดของ MoE ในยุคแรกเริ่ม มันไม่ได้มี 8 โมเดลเต็มๆ ซ้อนกันอยู่ แต่มันมี Feed-Forward Network (เครือข่ายประมวลผลข้อมูลส่วนหน้า) หรือ FFN ที่ถูกแบ่งออกเป็น 8 ส่วน ซึ่งทำงานเหมือนผู้เชี่ยวชาญแยกกันในแต่ละชั้น
เมื่อเวลาผ่านไป นักพัฒนาเริ่มเห็นว่าเราสามารถแบ่งผู้เชี่ยวชาญให้ละเอียดขึ้นได้อีก แทนที่จะมีผู้เชี่ยวชาญตัวใหญ่ 8 ตัว เราอาจมีผู้เชี่ยวชาญตัวเล็กๆ 100 ตัวที่ทำงานเฉพาะทางมากขึ้น DeepSeek-V3 จึงต่อยอดแนวคิดนี้ด้วยการเพิ่มจำนวนผู้เชี่ยวชาญให้มากขึ้นไปอีก จนถึงระดับหลายร้อยตัวต่อชั้น
การเพิ่มจำนวนผู้เชี่ยวชาญไม่ได้ทำให้ AI ช้าลง เพราะตัว Router (ตัวคัดเลือกเส้นทาง) ยังคงเลือกใช้ผู้เชี่ยวชาญเพียงแค่ไม่กี่ตัวต่อการประมวลผลหนึ่งคำ ผลลัพธ์คือเราได้ AI ที่มีความรู้กว้างขวางเหมือนห้องสมุดขนาดใหญ่ แต่ใช้เวลาค้นหาข้อมูลรวดเร็วเหมือนการเปิดดิกชันนารีหน้าเดียว
เจาะลึกกลไกการทำงานของ LatentMoE
ความท้าทายของโมเดลขนาดใหญ่คือข้อมูลต้องเดินทางผ่านหน่วยความจำของ GPU (การ์ดจอที่ใช้คำนวณงาน AI) จำนวนมาก LatentMoE จึงถูกออกแบบมาเพื่อบีบอัดเส้นทางที่ข้อมูลต้องวิ่งผ่าน เพื่อให้ผู้เชี่ยวชาญทำงานได้ในพื้นที่ที่เล็กลงและประหยัดพลังงานมากขึ้น
ลองจินตนาการถึงท่อส่งน้ำขนาดใหญ่ ถ้าเราส่งน้ำไปทุกท่อพร้อมกัน น้ำจะแรงน้อยและเสียเวลา แต่ถ้าเรามีระบบวาล์วที่เก่งพอจะเลือกเปิดเฉพาะท่อที่ต้องการ LatentMoE ก็เปรียบเสมือนระบบวาล์วอัจฉริยะที่บีบอัดข้อมูลให้วิ่งผ่านเฉพาะจุดที่จำเป็น ทำให้โมเดลระดับล้านล้านพารามิเตอร์ทำงานได้อย่างราบรื่น
สำหรับมือใหม่ที่หัดเขียนโปรแกรม คุณอาจจะมองว่าสิ่งนี้เหมือนการทำ Caching (การพักข้อมูลไว้ใช้ซ้ำ) ในฐานข้อมูลแทนที่จะไปดึงข้อมูลใหม่จากดิสก์ทุกครั้ง การทำแบบนี้ช่วยลดคอขวดของระบบและทำให้ AI ตอบโต้กับเราได้รวดเร็วทันใจแม้จะมีความรู้มหาศาลอยู่ในตัว
Kimi K3 กับความเสถียรของโมเดลขนาดใหญ่
Kimi K3 ก้าวข้ามขีดจำกัดเดิมด้วยการใช้ผู้เชี่ยวชาญเกือบ 900 ตัวต่อชั้น ซึ่งสร้างความท้าทายเรื่องความเสถียรอย่างมาก เพราะถ้าตัวคัดเลือกเส้นทางเลือกผิดพลาดเพียงนิดเดียว ผลลัพธ์ของ AI อาจจะมั่วหรือไม่สมเหตุสมผลได้ทันที
ทางแก้ของ K3 คือการนำหลักการของ Stable LatentMoE (การจัดระเบียบเส้นทางแบบเสถียร) มาใช้ เพื่อให้แน่ใจว่าการกระจายงานไปให้ผู้เชี่ยวชาญทั้ง 896 ตัวมีความสมดุล ไม่ใช่ว่ามีผู้เชี่ยวชาญเพียงไม่กี่ตัวที่ต้องทำงานหนักอยู่ตลอดเวลา ในขณะที่ตัวอื่นว่างงาน
การทำงานของระบบนี้คล้ายกับการจัดตารางงานในทีมพัฒนาซอฟต์แวร์ ถ้าเราให้งานหนักกับโปรแกรมเมอร์แค่คนเดียว ระบบก็จะล่ม แต่ถ้าเรากระจายงานให้ทุกคนช่วยกันตามความถนัด ระบบก็จะเสถียรและทำงานได้ต่อเนื่อง นี่คือเหตุผลว่าทำไมโมเดลระดับล้านล้านพารามิเตอร์อย่าง K3 ถึงใช้งานได้จริงในปัจจุบัน
ตัวอย่างการจำลองการเลือกผู้เชี่ยวชาญด้วยโค้ด
เพื่อให้เห็นภาพชัดเจน เราลองมาดูโค้ดจำลองการทำงานของ Router ง่ายๆ ว่ามันเลือกผู้เชี่ยวชาญอย่างไร
# จำลอง Router เลือกผู้เชี่ยวชาญ 2 คนจากทั้งหมด 8 คน
import random

def select_experts(token_data, num_experts=8, top_k=2):
    # สุ่มคะแนนให้ผู้เชี่ยวชาญแต่ละคน
    scores = {i: random.random() for i in range(num_experts)}
    # เรียงลำดับคะแนนจากมากไปน้อย
    sorted_experts = sorted(scores, key=scores.get, reverse=True)
    # เลือกมาแค่ 2 คนที่คะแนนดีที่สุด
    return sorted_experts[:top_k]

# จำลองคำที่ AI กำลังประมวลผล
token = "การเขียนโปรแกรม"
chosen = select_experts(token)
print(f"คำว่า '{token}' เลือกใช้ผู้เชี่ยวชาญหมายเลข: {chosen}")
อธิบายโค้ดทีละส่วน: ฟังก์ชัน select_experts รับข้อมูลคำและจำนวนผู้เชี่ยวชาญมาประมวลผล จากนั้นบรรทัด scores จะเป็นการสุ่มค่าความถนัด บรรทัด sorted คือการจัดลำดับความเก่ง และ [:top_k] คือการหยิบเฉพาะคนที่เก่งที่สุดมาช่วยงาน
ผลลัพธ์ที่ควรเห็นตอนรันจริง:
คำว่า 'การเขียนโปรแกรม' เลือกใช้ผู้เชี่ยวชาญหมายเลข: [3, 7]หมายเหตุ: ในการใช้งานจริง Router จะไม่ได้สุ่ม แต่จะใช้ค่า Weight (ค่าน้ำหนักที่เรียนรู้มา) เพื่อตัดสินใจเลือกผู้เชี่ยวชาญที่แม่นยำที่สุดตามบริบทของคำนั้นๆ
สรุป: การนำแนวคิด MoE ไปใช้พัฒนาตนเอง
การที่โมเดลอย่าง Kimi K3 สามารถจัดการผู้เชี่ยวชาญได้เกือบ 900 ตัว ไม่ใช่เรื่องบังเอิญ แต่เป็นผลจากการออกแบบที่ชาญฉลาดเพื่อให้ได้ผลลัพธ์สูงสุดโดยใช้ทรัพยากรที่คุ้มค่าที่สุด ในฐานะโปรแกรมเมอร์ คุณสามารถนำแนวคิดนี้ไปใช้กับการเรียนรู้ของตัวเองได้เช่นกัน
อย่าพยายามเรียนรู้ทุกอย่างในโลกพร้อมกัน แต่ให้เรียนรู้ที่จะเป็น Router (ตัวคัดเลือกเส้นทาง) ให้ตัวเอง เมื่อต้องแก้บั๊กหรือทำโปรเจกต์ใหม่ ให้ฝึกเลือก "ผู้เชี่ยวชาญ" หรือแหล่งข้อมูลที่ถูกต้องที่สุดสำหรับปัญหานั้นๆ แทนที่จะอ่านทุกอย่างแบบไม่เลือกหน้า
สุดท้ายนี้ จำไว้ว่าความเก่งไม่ได้อยู่ที่การมี Parameters (พารามิเตอร์หรือหน่วยความจำในโมเดล) เยอะที่สุด แต่อยู่ที่การเลือกใช้ส่วนประกอบที่มีอยู่ให้เกิดประสิทธิภาพสูงสุด เหมือนกับโมเดล MoE ที่เลือกทำงานเฉพาะสิ่งที่จำเป็น เพื่อสร้างคำตอบที่ชาญฉลาดและรวดเร็วที่สุดให้กับผู้ใช้นั่นเอง
ที่มา: From Mixtral to Kimi K3: How Mixture-of-Experts Models Evolved — freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More